采集规则编写教材
本文为 EnovelCms 采集工具的采集规则编写教程。在使用EnovelCms提供的配套采集辅助工具前,请务必确认内容版权合规。本教程仅用于指导批量抓取已取得合法授权的作品,比如代理、授权等方式的接口渠道;若未获得对应内容版权,严禁使用本采集工具。尊重知识产权是公民的法定义务,请切勿实施违规采集行为。
采集工具的形式
1、EnovelCms内置采集器:该程序与EnovelCms集成,采集效率低,仅适用于小范围数据抓取;
2、EnovelCms本地采集器:该采集器使用py开发,打包成exe文件,可在本地电脑进行采集并上传到EnovelCms网站;
3、Api接口数据传递:该模式理论上适配任何采集软件以及通过第三方资源接口直接获取数据。
二、采集规则编写
由于本地采集器与内置采集器的采集规则大同小异,基本一致,本教程将以内置采集规则编写为例。
首先我们需要了解采集工具适用的通配符:
通配符说明:{num} 纯数字 | {str} 任意非空白字符 | {blank} 空格 | {rn} 换行符动态URL变量: {novel_id}、{chapter_id}、{novel_id/1000}(取整)、{page}(分页)分页支持: 在章节列表URL中使用 {page} 变量,并配置总页数提取规则即可自动采集所有分页章节。章节内容分页: 类似配置 content_page_url 和总页数提取规则,内容将自动合并。
通配符支持替代不固定但符合预置通配符类型的字符串!
1、找到目标网站
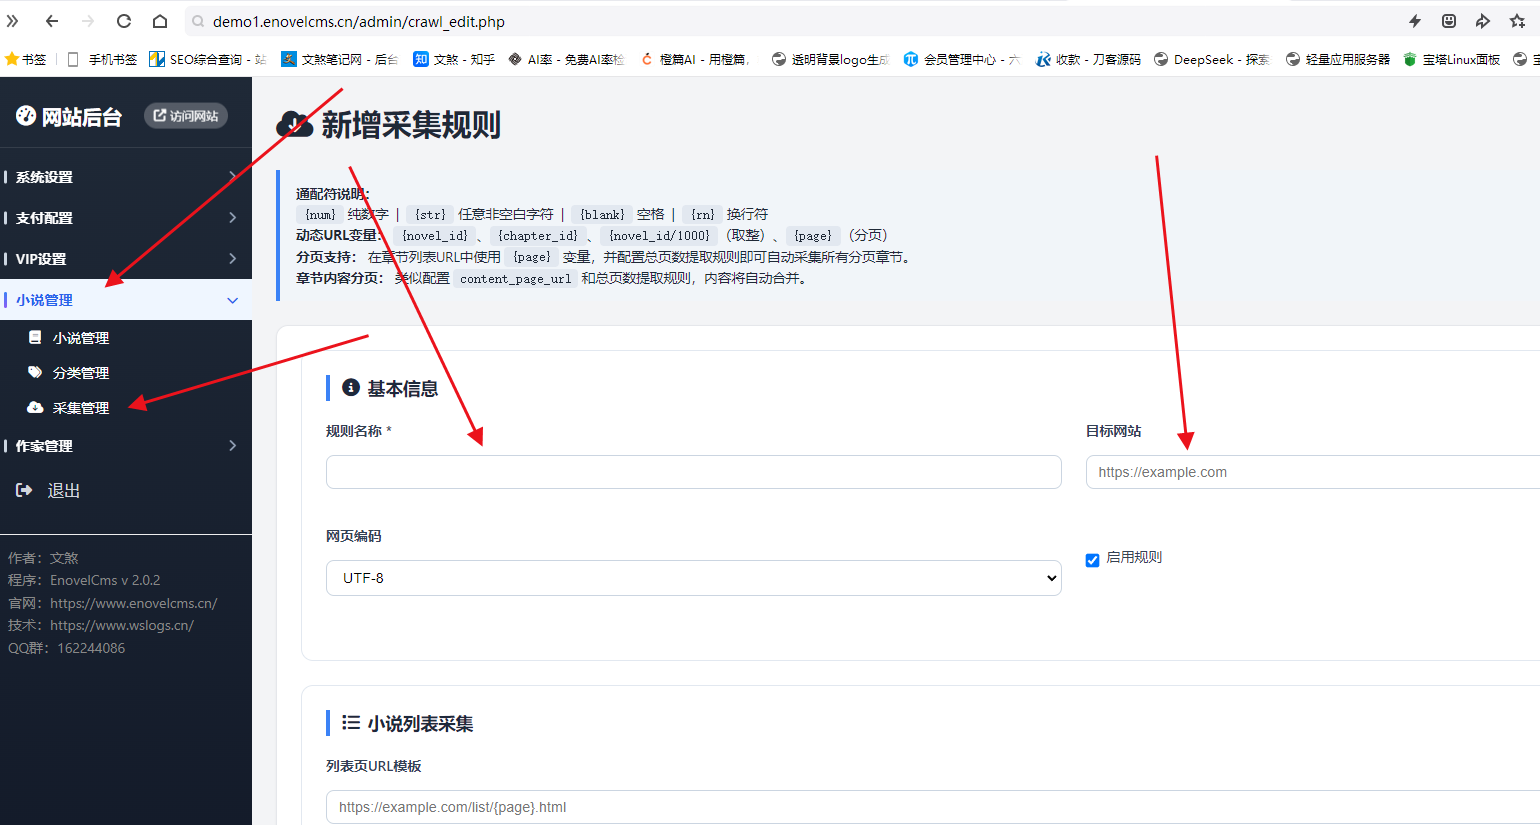
例子:https://www.xxx.com/ 然后找到EnovelCms程序的后台,小说管理--》采集管理--》新增采集规则--》,规则名称随便编写,目标网站填写你已获得授权的网站url。
 2、什么是小说列表采集?
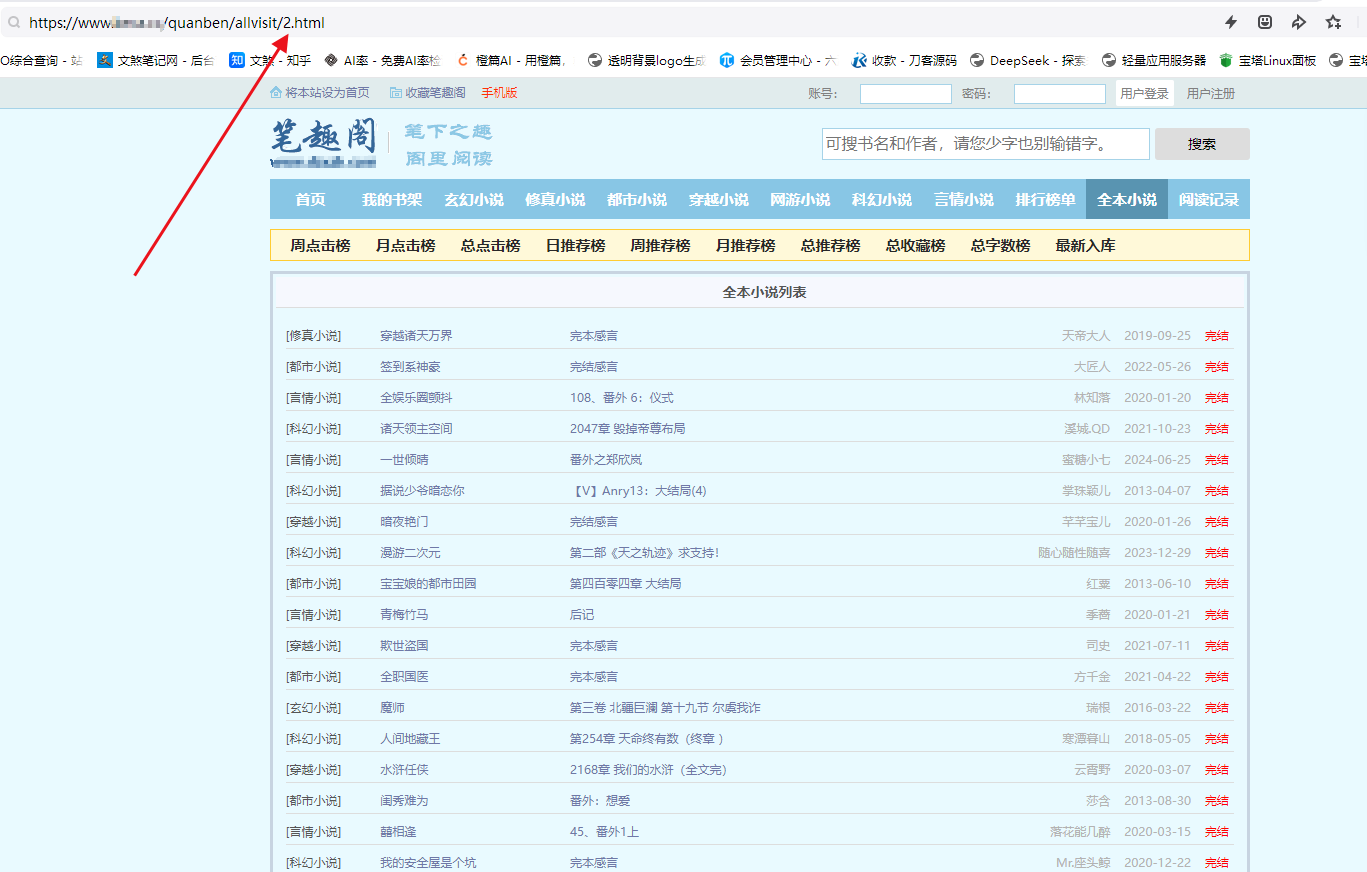
小说列表采集,就是采集大量小说的列表页,一般网站都有分类分页,列表页URL模板就是分类分页的URL,如果该网站存在多个分页,可以把分页数字替换成{page},采集工具会从1逐渐增加。
3、什么是采集区域?
采集区域是本辅助工具所独有的,很多采集软件没有这一项(比如关关采集器),采集器区域的意思是锁定指定的区域,然后你需要的数据以及采集规则都只需要考虑采集区域内的代码。
目标站代码案例:
<div id="toplist">
	<h2>全本小说列表</h2>
    <ul>
                <li>
            <span class="s1">[修真小说]</span>
            <span class="s2"><a href="/xs/10930/" target="_blank">穿越诸天万界</a></span>
            <span class="s3"><a href="/xs/10930/4859920.html" target="_blank">完本感言</a></span>
            <span class="s4">天帝大人</span>
            <span class="s5">2019-09-25</span>
            <span class="s6"><font color="red">完结</font></span>
        </li>
                <li>
            <span class="s1">[都市小说]</span>
            <span class="s2"><a href="/xs/8879/" target="_blank">签到系神豪</a></span>
            <span class="s3"><a href="/xs/8879/22843341.html" target="_blank">完结感言</a></span>
            <span class="s4">大匠人</span>
            <span class="s5">2022-05-26</span>
            <span class="s6"><font color="red">完结</font></span>
        </li>
                <li>
            <span class="s1">[言情小说]</span>
            <span class="s2"><a href="/xs/5544/" target="_blank">全娱乐圈颤抖</a></span>
            <span class="s3"><a href="/xs/5544/2353637.html" target="_blank">108、番外 6:仪式</a></span>
            <span class="s4">林知落</span>
            <span class="s5">2020-01-20</span>
            <span class="s6"><font color="red">完结</font></span>
        </li>

            </ul>
	<div class="clear"></div>
</div>
第一步:这里我们编写采集小说页的规则大致如下:
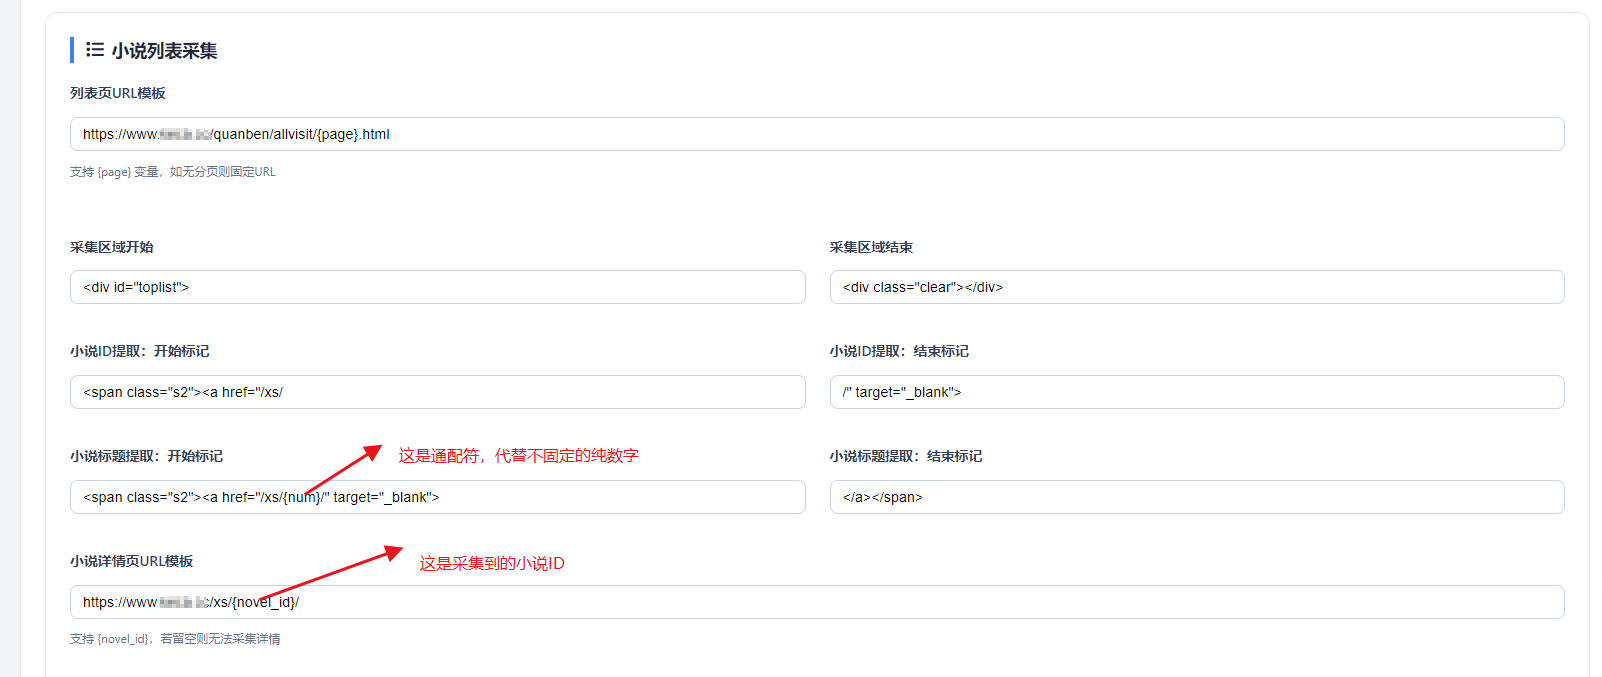
到这里,小说列表的采集规则基本完成,我们可以保存以后,测试采集规则,如果可以采集到小说ID和小说标题,那么这一步的采集规则就没有问题了!后续采集小说信息就会自动调用小说详情页URL模板里的内容。
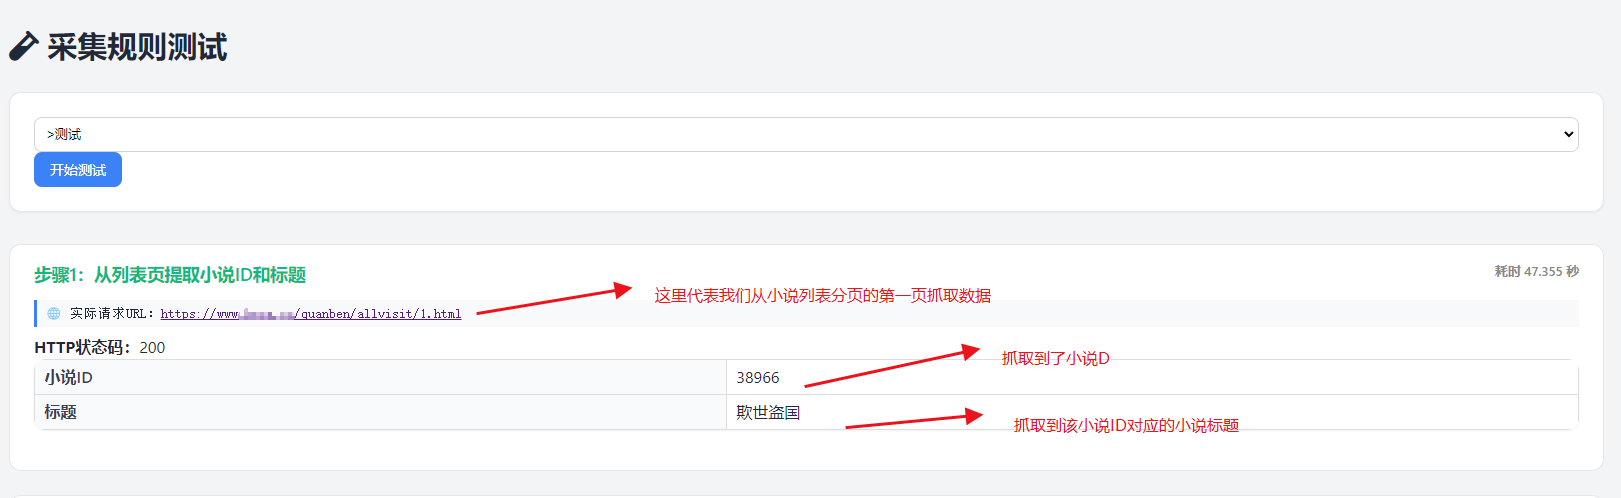 第二步:上面我们通过测试,已经确定可以采集到小说,接下来我们就需要采集小说的信息,比如作者、连载状态、小说简介等,这里的规则编写逻辑与小说列表采集的编写逻辑一致。唯一不同的有两个地方,就是处理连载状态和分类映射的地方。
我们首先通过字符串截取(第一步的教程)取得连载状态关键字,通常是完本、完结、已完结、连载中等。然后设置完结关键词,如果采集到的状态与完结关键字一样,那么久视为该小说已完结。
关于分类映射,我们采集到的分类名分别每一个对应本站的一个分类,可以是多对一,就是采集到的多个分类对应本站的一个分类。
其他的与第一步没有任何区别。
=========================================
下面是以 EnovelCms 内置采集器为准编写的一个完整案例教程,本系统配套的本地采集器编写采集规则的方法与它是一致的。
一、进入采集规则编辑页面
后台 → 小说管理 → 采集管理 → 新增规则 / 编辑规则。
页面从上到下分为:
基本信息
小说列表采集
小说信息提取
分卷与章节列表
章节内容提取
封面处理
内容过滤与防采集
每个字段怎么填,下面按顺序讲。
二、先记住两个东西:通配符和 URL 变量
页面上方有一个“通配符说明”提示框,内容就是这些。
1. 开始/结束标记里可用的通配符
| 通配符 | 含义 | 示例 |
|---|---|---|
{num} | 纯数字 | href="/read/{num}/ |
{str} | 任意非空白字符 | >{str}< |
{blank} | 空格 | 作者{blank}: |
{rn} | 换行符 | {rn} |
它们用在“开始标记”或“结束标记”里,代替会变化的部分。
2. URL 模板里可用的变量
| 变量 | 作用 | 用在哪 |
|---|---|---|
{page} | 页码 | 列表页、章节列表、内容分页 |
{novel_id} | 源站小说 ID | 详情页、章节列表、章节内容 |
{chapter_id} | 源站章节 ID | 章节内容 URL |
{novel_id/1000} | 小说 ID 除以 1000 取整 | 部分站点按 ID 分目录 |
例子:
https://example.com/list/{page}.html
https://example.com/book/{novel_id}/
https://example.com/read/{novel_id}/{chapter_id}.html
三、按页面字段一步步填写
第 1 步:基本信息
| 页面字段 | 怎么填 |
|---|---|
| 规则名称 | 随便写,比如“演示小说站” |
| 目标网站 | 填源站首页,比如 https://example.com |
| 网页编码 | 大部分选 UTF-8,老站选 GBK |
| 启用规则 | 勾上 |
第 2 步:小说列表采集
打开源站列表页,F12 看源码。
假设列表页 HTML:
<div class="book-list">
  <a href="/book/1001/">斗破苍穹</a>
  <a href="/book/1002/">凡人修仙传</a></div>
列表页 URL 是:
https://example.com/list/1.html
https://example.com/list/2.html
在页面上这样填:
| 页面字段 | 填写内容 |
|---|---|
| 列表页URL模板 | https://example.com/list/{page}.html |
| 采集区域开始 | <div class="book-list"> |
| 采集区域结束 | </div> |
| 小说ID提取:开始标记 | href="/book/ |
| 小说ID提取:结束标记 | /"> |
| 小说标题提取:开始标记 | "> |
| 小说标题提取:结束标记 | </a> |
| 小说详情页URL模板 | https://example.com/book/{novel_id}/ |
解释:
<a href="/book/1001/">斗破苍穹</a>
开始标记
href="/book/之后是1001结束标记
/">之前是1001所以提取出小说 ID:
1001开始标记
">之后是斗破苍穹结束标记
</a>之前是斗破苍穹所以提取出标题。
第 3 步:小说信息提取
打开详情页,F12 看源码。
假设详情页 HTML:
<div id="info">
  <h1>斗破苍穹</h1>
  <p>作者:天蚕土豆</p>
  <p>分类:玄幻</p>
  <div class="intro">这里是简介内容...</div>
  <img class="cover" src="/images/cover/1001.jpg">
  <p>状态:连载中</p></div>
在页面上这样填:
| 页面字段 | 填写内容 |
|---|---|
| 采集区域开始 | <div id="info"> |
| 采集区域结束 | </div> |
| 书名开始 | <h1> |
| 书名结束 | </h1> |
| 作者开始 | 作者: |
| 作者结束 | </p> |
| 分类开始 | 分类: |
| 分类结束 | </p> |
| 简介开始 | <div class="intro"> |
| 简介结束 | </div> |
| 封面开始 | <img class="cover" src=" |
| 封面结束 | " |
| 状态开始 | 状态: |
| 状态结束 | </p> |
| 完结关键词 | 完结,完本 |
说明:
“采集区域”是先把整个详情区域框出来,后面的书名、作者等都在这个区域里找,避免找到页面其他地方的文字。
状态提取出来后,如果里面包含“完结”或“完本”,系统会把小说标记为已完结。
分类映射在下面单独讲。
第 4 步:分卷与章节列表
打开章节列表页,F12 看源码。
假设章节列表 HTML:
<div class="chapters">
  <h3>第一卷 初入江湖</h3>
  <a href="/read/1001/2001.html">第一章 入山</a>
  <a href="/read/1001/2002.html">第二章 拜师</a>

  <h3>第二卷 风起云涌</h3>
  <a href="/read/1001/2003.html">第三章 出山</a></div><div class="total-pages">共 3 页</div>
章节列表 URL 可能是:
https://example.com/book/1001/chapters_1.html
https://example.com/book/1001/chapters_2.html
在页面上这样填:
| 页面字段 | 填写内容 |
|---|---|
| 章节列表页URL模板 | https://example.com/book/{novel_id}/chapters_{page}.html |
| 采集区域开始 | <div class="chapters"> |
| 采集区域结束 | </div> |
| 卷名开始标记 | <h3> |
| 卷名结束标记 | </h3> |
| 章节ID提取:开始标记 | href="/read/{num}/ |
| 章节ID提取:结束标记 | .html |
| 章节标题提取:开始标记 | > |
| 章节标题提取:结束标记 | </a> |
| 章节详情页URL模板 | https://example.com/read/{novel_id}/{chapter_id}.html |
| 章节列表总页数开始 | <div class="total-pages"> |
| 章节列表总页数结束 | </div> |
重点解释章节 ID:
<a href="/read/1001/2001.html">第一章 入山</a>
如果写死
href="/read/1001/,换一本小说就不对了。所以开始标记写
href="/read/{num}/,{num}会匹配1001。结束标记写
.html,捕获.html之前的内容,也就是2001。
卷名:
有
<h3>卷名时,系统会把后面的章节归到该卷。没有卷名的章节会归到“默认卷”。
总页数:
<div class="total-pages">共 3 页</div>
系统会取第一个数字 3,然后自动采 3 页。
注意:总页数区域不要放一堆页码链接,否则可能取到 1。
第 5 步:章节内容提取
打开章节内容页,F12 看源码。
假设内容 HTML:
<div id="content">
  <p>正文第一段</p>
  <p>正文第二段</p></div><div class="total-pages">共 2 页</div>
在页面上这样填:
| 页面字段 | 填写内容 |
|---|---|
| 内容开始 | <div id="content"> |
| 内容结束 | </div> |
| 内容分页URL模板 | {chapter_url}?page={page} |
| 内容分页总页数开始 | <div class="total-pages"> |
| 内容分页总页数结束 | </div> |
说明:
如果章节内容不分页,只填“内容开始”和“内容结束”就行,分页字段留空。
如果内容分页,第一页也会用
内容分页URL模板生成。所以要确保?page=1能正常访问第一页。如果第一页不是
?page=1这种格式,建议不要填内容分页模板,或者改成正确的格式。
第 6 步:封面处理
| 页面字段 | 填写内容 |
|---|---|
| 忽略封面URL特征 | 比如 nocover.jpg |
封面 URL 里包含这个关键词就不下载,直接忽略。
第 7 步:内容过滤与防采集
| 页面字段 | 填写内容 |
|---|---|
| 过滤黑名单 | 每行一个关键词,正文里出现就删掉。例如:本站首发请勿转载手机阅读 |
| 随机插入字符 | 每行一个字符串,系统会随机取一个追加到章节末尾。例如:EnovelCms小说站 |
这个主要用于去掉源站广告和做简单标记。
四、分类映射怎么填
在“小说信息提取”区域下方有一个“分类映射”。
先在本站后台“分类管理”里建好分类,比如:
| ID | 分类名 |
|---|---|
| 1 | 玄幻 |
| 2 | 仙侠 |
| 3 | 都市 |
然后在采集规则编辑页面:
左边填源站分类名
右边下拉选择本站分类
例如:
| 源分类 | 本站分类 |
|---|---|
| 玄幻 | 玄幻 |
| 东方玄幻 | 玄幻 |
| 仙侠 | 仙侠 |
| 修真 | 仙侠 |
如果源站分类没在映射里,系统会自动归到本站第一个分类。
五、完整示例:按页面字段填写
假设目标站:
列表页:
https://example.com/list/1.html详情页:
https://example.com/book/1001/章节列表:
https://example.com/book/1001/chapters_1.html章节内容:
https://example.com/read/1001/2001.html
列表页 HTML:
<div class="book-list">
  <a href="/book/1001/">斗破苍穹</a></div>
详情页 HTML:
<div id="info">
  <h1>斗破苍穹</h1>
  <p>作者:天蚕土豆</p>
  <p>分类:玄幻</p>
  <div class="intro">这里是简介...</div>
  <img class="cover" src="/images/cover/1001.jpg">
  <p>状态:连载中</p></div>
章节列表 HTML:
<div class="chapters">
  <h3>第一卷 初入江湖</h3>
  <a href="/read/1001/2001.html">第一章 入山</a></div><div class="total-pages">共 3 页</div>
内容页 HTML:
<div id="content">
  <p>正文第一段</p></div>
页面填写如下:
基本信息
规则名称:演示小说站
目标网站:
https://example.com网页编码:UTF-8
启用规则:勾选
小说列表采集
列表页URL模板:
https://example.com/list/{page}.html采集区域开始:
<div class="book-list">采集区域结束:
</div>小说ID提取:开始标记:
href="/book/小说ID提取:结束标记:
/">小说标题提取:开始标记:
">小说标题提取:结束标记:
</a>小说详情页URL模板:
https://example.com/book/{novel_id}/
小说信息提取
采集区域开始:
<div id="info">采集区域结束:
</div>书名开始:
<h1>书名结束:
</h1>作者开始:
作者:作者结束:
</p>分类开始:
分类:分类结束:
</p>简介开始:
<div class="intro">简介结束:
</div>封面开始:
<img class="cover" src="封面结束:
"状态开始:
状态:状态结束:
</p>完结关键词:
完结,完本分类映射:玄幻 → 玄幻(本站对应分类)
分卷与章节列表
章节列表页URL模板:
https://example.com/book/{novel_id}/chapters_{page}.html采集区域开始:
<div class="chapters">采集区域结束:
</div>卷名开始标记:
<h3>卷名结束标记:
</h3>章节ID提取:开始标记:
href="/read/{num}/章节ID提取:结束标记:
.html章节标题提取:开始标记:
>章节标题提取:结束标记:
</a>章节详情页URL模板:
https://example.com/read/{novel_id}/{chapter_id}.html章节列表总页数开始:
<div class="total-pages">章节列表总页数结束:
</div>
章节内容提取
内容开始:
<div id="content">内容结束:
</div>内容分页URL模板:留空(如果内容不分页)
内容分页总页数开始:留空
内容分页总页数结束:留空
封面处理
忽略封面URL特征:留空
内容过滤与防采集
过滤黑名单:留空
随机插入字符:留空
填完点“保存规则”。
六、测试和采集
保存后,回到“采集规则管理”页面。
点“测试”
打开测试页面,会显示 4 步:重点看每一步的实际请求 URL 和提取结果。
如果某一步为空,就回到编辑页面检查对应的开始/结束标记。步骤1:列表页提取小说 ID 和标题
步骤2:详情页提取书名、作者、分类、简介、封面、状态
步骤3:章节列表提取分卷和章节
步骤4:随机章节内容采集
测试通过后,点“采集”
系统会从列表页开始,自动依次执行:采集过程中会显示进度,网络错误会自动重试。
列表页 → 详情页 → 章节列表 → 章节内容
如果只想采某一本,点“单篇”
输入源站小说 ID,支持:单个:
1001范围:
1-100列表:
1,5,20
七、常见问题
1. 提取出来是空的
开始/结束标记要和源码完全一致,包括引号、空格。
注意编码,GBK 站点要选 GBK。
如果页面是 JS 动态加载的,cURL 抓不到,只能采静态 HTML 或接口。
2. 章节 ID 提取不对
不要写死小说 ID。
错误:href="/read/1001/
正确:href="/read/{num}/
3. 总页数取错
总页数区域最好只放“共 X 页”,不要放页码链接。
否则系统取第一个数字,可能取到 1。
4. 内容分页第一页失败
如果配了 {chapter_url}?page={page},第一页会请求 ?page=1。
如果源站第一页不接受这个参数,就不要填内容分页模板。
5. 采集很慢或中断
采集是浏览器逐步跳转执行的,章节多时要保持页面打开。
网络错误会自动重试,非网络错误会跳过。